
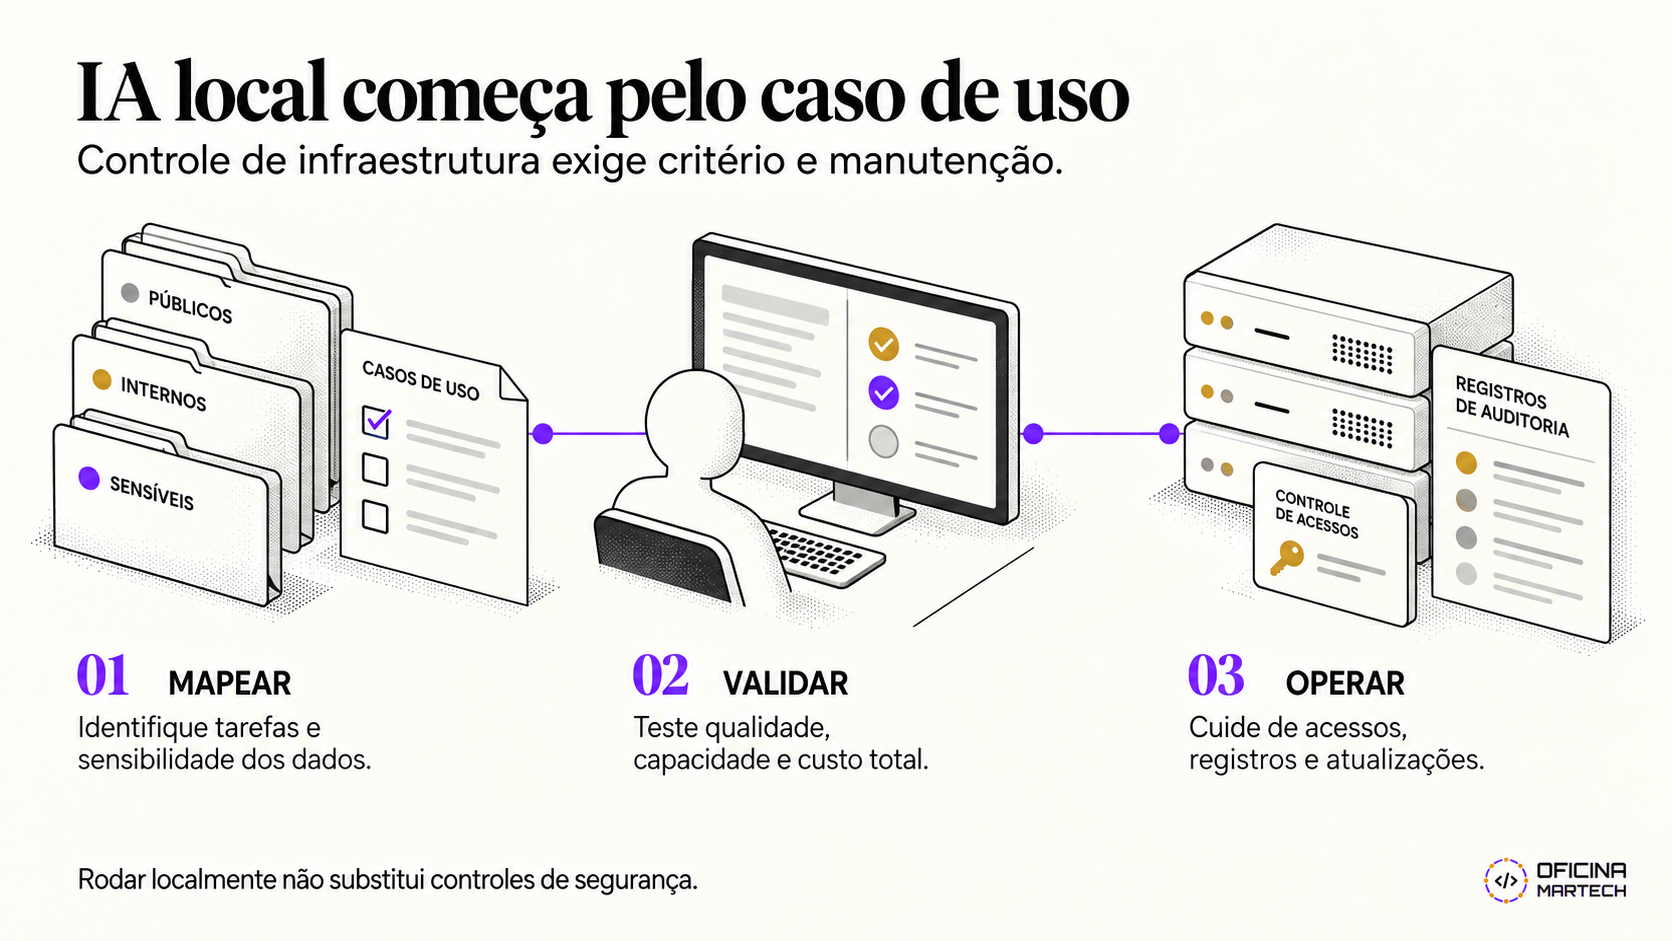
 Resumo visual do artigo
Por anos, rodar modelos de inteligência artificial dentro da própria infraestrutura era privilégio de empresas com orçamentos generosos e equipes de engenharia dedicadas. Esse cenário mudou.
Modelos com pesos disponíveis podem viabilizar execução local. A escolha exige verificar licença, memória, qualidade na tarefa e capacidade de manutenção, além das regras de tratamento dos dados.
Este guia é para o gestor de tecnologia ou o CEO de PME que precisa entender o que é IA local, quando faz sentido adotar, quanto custa e por onde começar.
O que é IA local — e por que não é mais privilégio de grandes corporações
IA local significa rodar modelos de linguagem diretamente na infraestrutura da sua empresa: no servidor da empresa, em máquinas on-premise ou em hardware dedicado dentro das suas instalações. A permanência dos dados no ambiente depende da arquitetura e das conexões habilitadas.
Para manter a inferência local, verifique também embeddings, ferramentas, telemetria, backups e APIs externas. O Ollama, por exemplo, distingue execução local de recursos em nuvem e permite desabilitar estes últimos.
O uso responsável de IA continua necessário: controlar a infraestrutura não substitui revisão e governança.
A diferença entre IA local, on-premise e edge AI
IA local é o termo mais amplo. Inclui qualquer modelo rodando fora de nuvem pública.
On-premise especifica que o hardware está fisicamente nas instalações da empresa. Maior controle, maior investimento inicial.
Edge AI é IA local em dispositivos de borda: câmeras, sensores, máquinas industriais. Processamento próximo ao ponto de coleta, com menor dependência de comunicação remota quando a arquitetura permite.
Para a maioria das PMEs, a escolha relevante é entre IA local em servidor próprio ou alugado (colocation) e APIs de nuvem de provedores como OpenAI, Anthropic e Google.
Pesos disponíveis não significam licença irrestrita
Antes de escolher um modelo, confirme a versão, a origem dos pesos, as condições de uso comercial e os requisitos do runtime. Modelos open-weight podem ter restrições próprias; não use o termo open-source como sinônimo automático.
Como comparar modelos para execução local
Use a mesma amostra de tarefas, critérios de precisão, idioma, contexto e latência. Registre também quantização, hardware, consumo de memória e custo de manutenção.
Modelos menores podem atender tarefas delimitadas, mas tamanho não garante qualidade. Arquiteturas MoE podem reduzir computação por token em certas condições; o número de parâmetros ativos não representa sozinho toda a memória necessária.
Evite escolher com base em um ranking genérico. Faça a seleção pelo teste do caso de uso e pela documentação oficial da versão considerada.
Ferramentas para colocar IA local para funcionar
Ollama, LM Studio e vLLM
Ollama e LM Studio são opções para experimentar execução local. vLLM é uma opção de serviço de inferência a avaliar quando há requisitos de concorrência e operação.
Não existe um resultado universal de tokens por segundo para uma ferramenta: modelo, quantização, hardware, contexto e volume de requisições mudam o resultado. Execute um teste com a carga esperada e registre latência, filas, falhas e memória.
O Ollama documenta processamento concorrente condicionado à memória disponível. A documentação do vLLM descreve recursos de execução e otimização; instalar o runtime não fornece, sozinho, SLA ou alta disponibilidade.
Hardware: o que a sua empresa realmente precisa
Dimensione memória e capacidade antes de comprar
Considere pesos, cache de contexto, memória temporária, sistema operacional e requisições simultâneas. Como cálculo aproximado apenas dos pesos, 7 bilhões de parâmetros em 16 bits ocupam 14 GB decimais; em 32 bits, 28 GB. Portanto, 8 GB de VRAM não comportam esses pesos integralmente nessas precisões.
Quantização, offload e execução distribuída podem alterar a configuração possível, com efeitos sobre velocidade e qualidade. Memória unificada também exige reservar espaço para o sistema e outros processos.
Quantização e validação
Quantização reduz a representação numérica dos pesos. O espaço final inclui metadados e outras estruturas; reduzir bits não garante a mesma redução na memória total nem um limite universal de perda de precisão. A documentação de quantização explica opções e limitações.
Teste a versão quantizada nas tarefas relevantes antes de aceitar o resultado. Para CPU ou GPU, meça latência e consumo no equipamento disponível. A adequação de uma placa ou máquina não pode ser deduzida apenas do número de parâmetros.
IA local vs API cloud: quando cada abordagem faz sentido
Calcule o custo total para seu volume
Compare hardware ou locação, energia, armazenamento, manutenção, equipe, licenças, observabilidade e redundância com as despesas de API e integração. Inclua cenários de uso baixo, esperado e alto.
Não há prazo universal de retorno nem um limite anual de gastos que torne uma arquitetura vencedora. O ponto de equilíbrio depende da utilização, da qualidade aceita, dos preços e da capacidade operacional.
Critérios de decisão
- Nuvem pode ser adequada quando o volume é irregular ou a equipe precisa reduzir a gestão de infraestrutura.
- Execução local pode ser adequada quando os controles de dados, a carga previsível e a capacidade técnica justificam a operação.
- Dados sensíveis exigem avaliação jurídica e de segurança em ambas as alternativas.
- Arquitetura híbrida exige regras explícitas sobre quais tarefas e dados podem atravessar cada fronteira.
IA local, LGPD e propostas de regulação
Na consulta de 21/09/2026, o PL 2338/2023 aguardava parecer na Comissão Especial da Câmara. A aprovação pelo Senado em 2024 não o tornou lei vigente. A LGPD já se aplica ao tratamento de dados pessoais, independentemente do local de inferência.
Execução local pode ampliar o controle operacional, mas não dispensa base legal, segurança, atendimento a direitos e retenção adequada. Audite também suporte remoto, backups e serviços conectados antes de afirmar que não há transferência internacional.
Logs ajudam a investigar incidentes quando são proporcionais à finalidade e protegidos. Dados na rede interna continuam sujeitos a acessos indevidos e falhas de segurança.
Acompanhe as normas da ANPD e a arquitetura efetivamente implantada. Escolher infraestrutura local, isoladamente, não comprova conformidade.
Ajuste de modelos, RAG e arquitetura híbrida
Fine-tuning pode ser avaliado quando há exemplos adequados e critérios claros. Compare seus resultados com alternativas mais simples antes de assumir ganho de custo ou precisão.
RAG conecta a geração a documentos recuperados. Uma configuração local exige que os documentos, embeddings, banco vetorial e modelo sejam processados no ambiente aprovado; ferramentas e integrações externas precisam de revisão separada.
Em arquitetura híbrida, defina roteamento por finalidade, dados e requisitos operacionais. Não há proporção universal de uso local e nuvem. Documente exceções e teste se as regras são cumpridas.
Por onde começar — um caminho prático para PMEs
A pergunta "por onde começo?" tem uma resposta sequencial.
Passo 1: Mapeie os casos de uso por sensibilidade de dados. Antes de escolher hardware ou modelo, classifique o que você quer automatizar com IA. Quais dados esses processos envolvem? Dados de clientes, documentos internos, informações estratégicas? Essa classificação define quais fluxos podem ir para nuvem e quais precisam ficar locais.
Passo 2: Valide com hardware que você já tem. Escolha um modelo e um runtime compatíveis com o equipamento disponível, após verificar licença, memória e suporte da versão. Teste uma amostra representativa de tarefas e compare qualidade, latência e custo do tempo da equipe antes de decidir por uma compra.
Passo 3: Avalie o ponto de equilíbrio financeiro. Some o custo atual de APIs externas (ou o custo projetado para o volume planejado). Compare com o custo de hardware, energia e administração de um servidor dedicado. Defina um horizonte de avaliação e compare cenários, incluindo capacidade de manutenção e qualidade.
Passo 4: Defina a arquitetura de produção. Escolha runtime, hardware e capacidade a partir de testes de carga e dos requisitos de latência, recuperação e disponibilidade. Redundância e balanceamento exigem desenho e testes próprios. Valide o modelo com dados representativos que possam ser usados com segurança antes da produção.
Passo 5: Estabeleça governança antes de escalar. Defina quem tem acesso ao endpoint local, como os logs são armazenados, qual é a política de atualização de modelos e como incidentes são tratados. Governança em IA local não é opcional: é o que transforma um projeto técnico em uma operação sustentável.
IA local é uma alternativa a avaliar com piloto, medição e governança. Os riscos e a viabilidade variam conforme a aplicação e a equipe.
A questão não é mais "é possível rodar IA localmente?" É "quando faz sentido para a minha operação?"
Se você está avaliando como estruturar o uso de inteligência artificial na sua empresa, seja com APIs em nuvem, self-hosting ou arquitetura híbrida, a Oficina Martech pode ajudar a mapear o caminho mais adequado para o seu contexto.
Agende uma conversa com a equipe da Oficina Martech.


