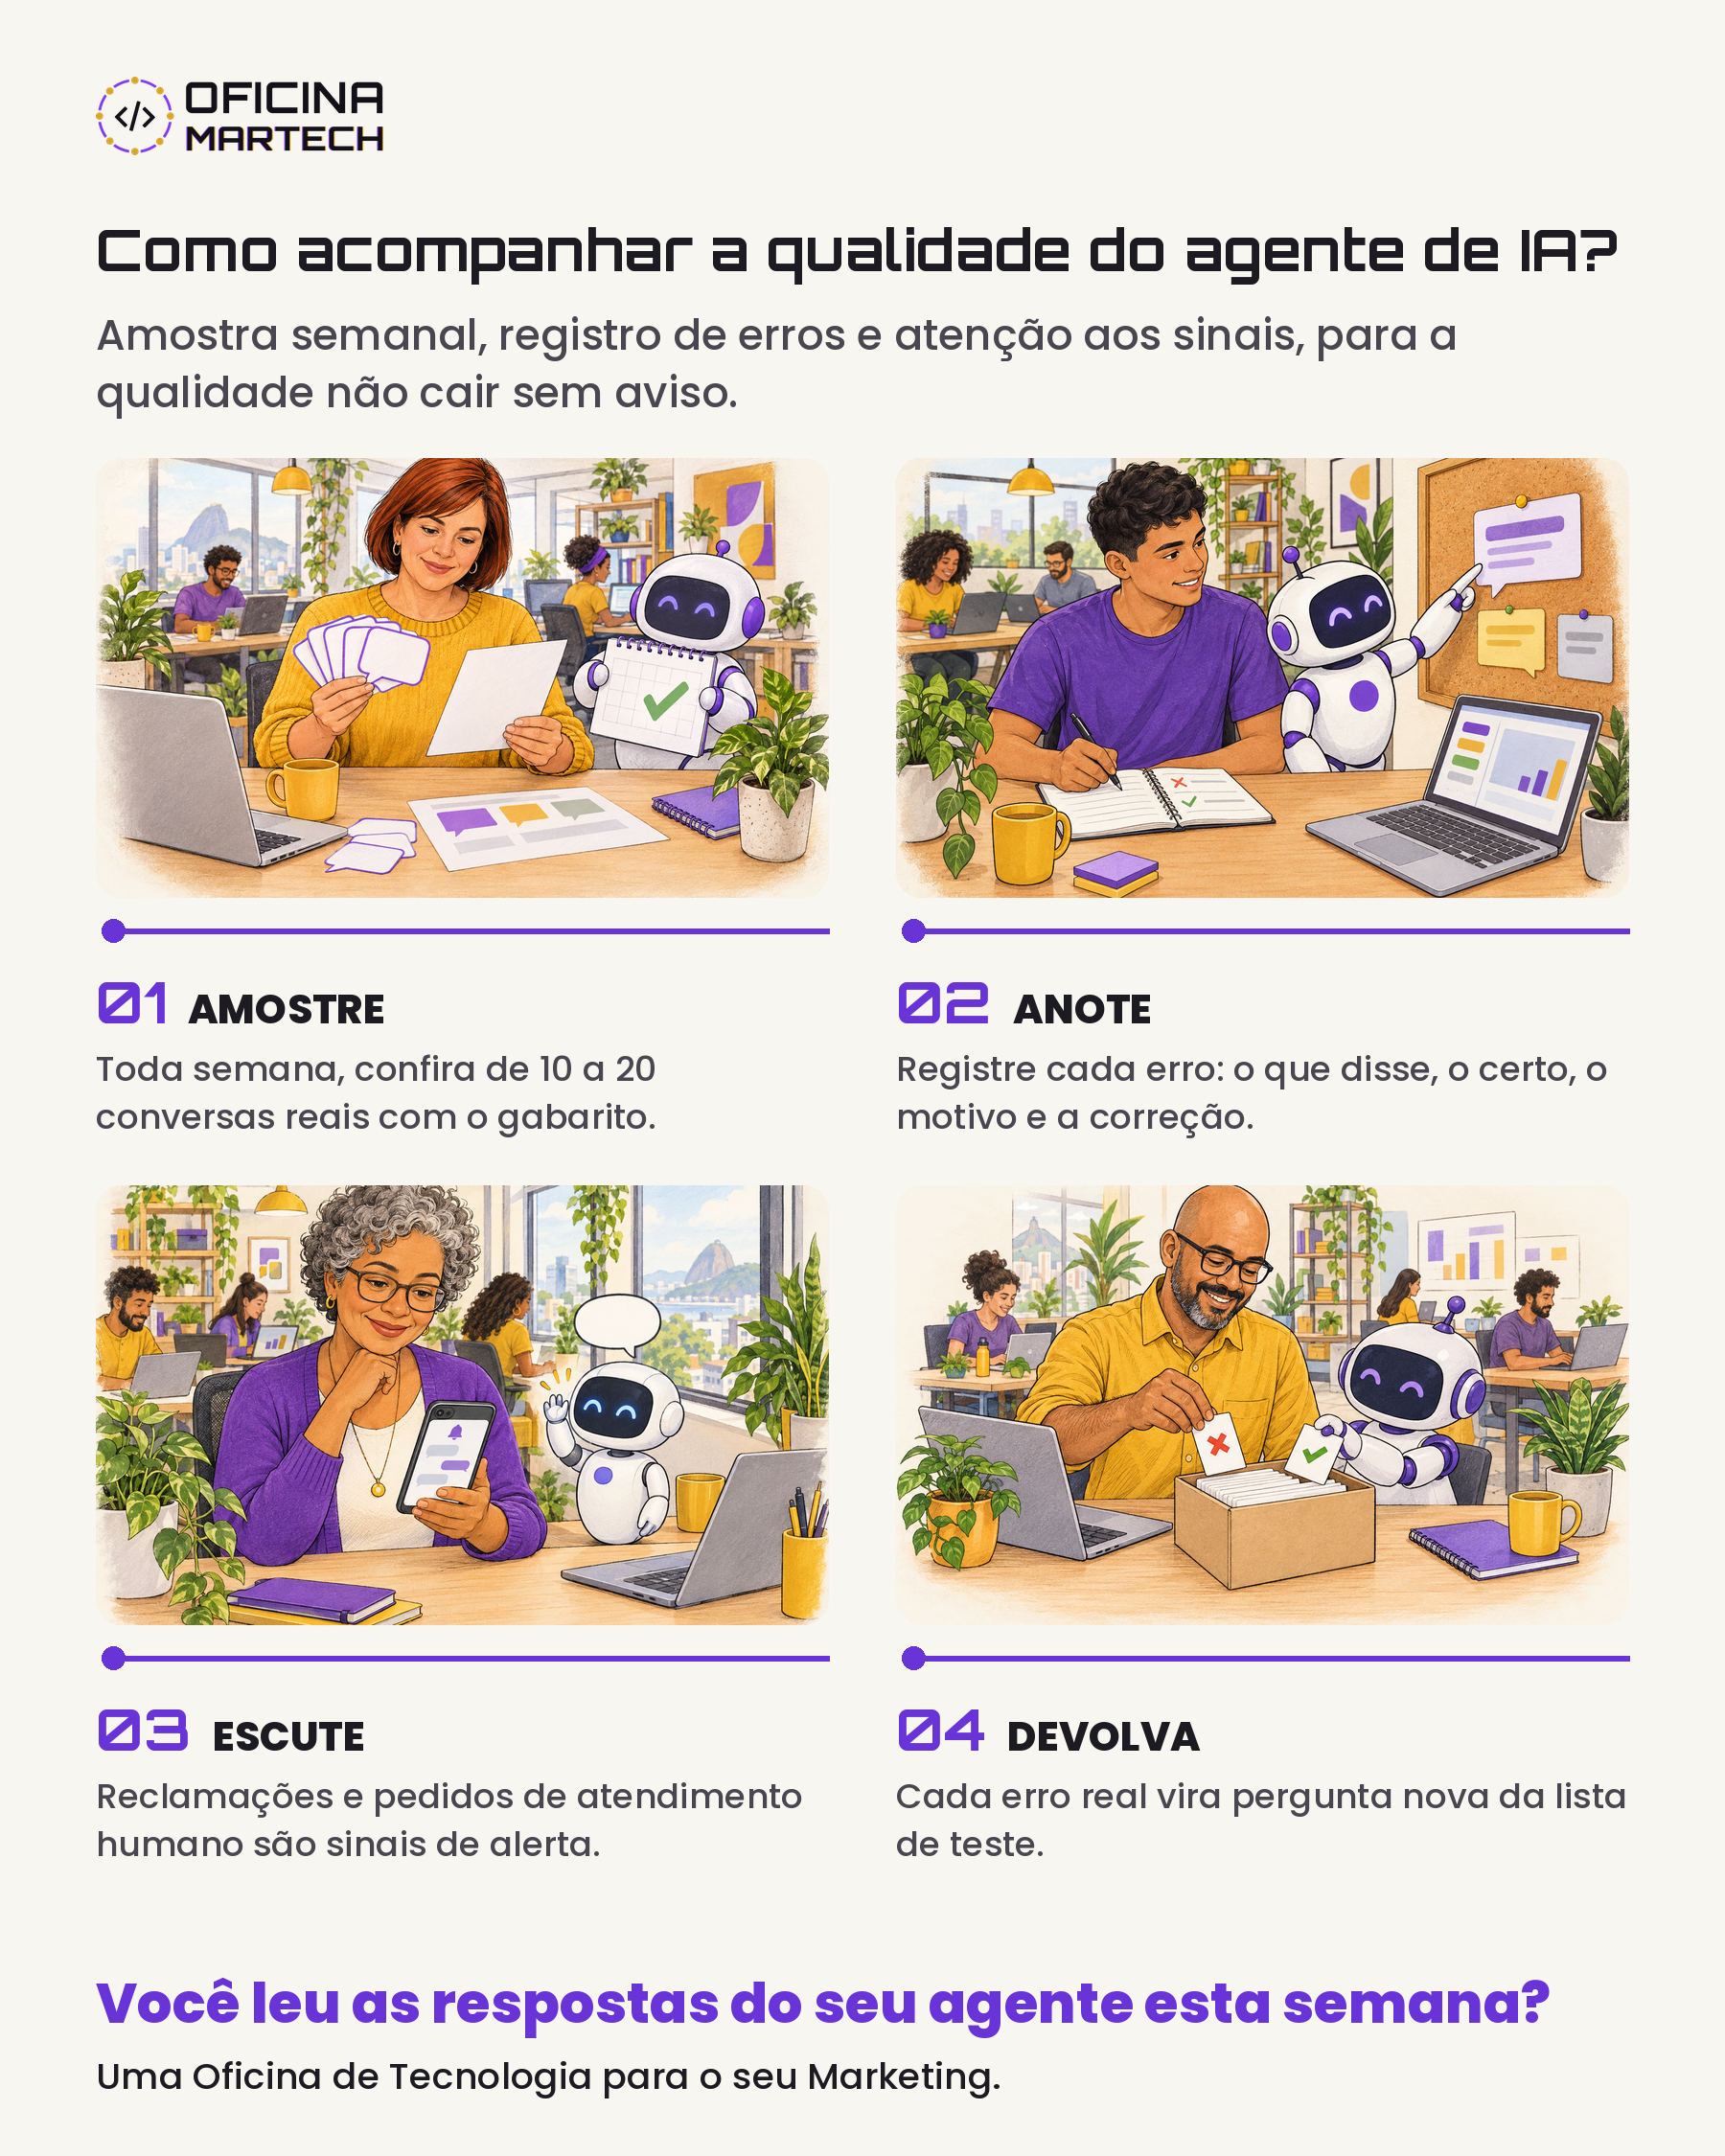
 Como acompanhar a qualidade do agente de IA: confira toda semana uma amostra de conversas reais com o gabarito, registre cada erro, trate reclamações e pedidos de atendimento humano como alerta e transforme cada erro em pergunta nova do teste
Para acompanhar a qualidade das respostas de um agente de IA no dia a dia, leia toda semana uma amostra de 10 a 20 conversas reais e compare cada resposta com o gabarito que você montou no teste. Anote cada erro num registro simples, trate reclamações e pedidos de atendimento humano como sinal de alerta e transforme todo erro real em pergunta nova da lista de teste. Com isso, uma queda de qualidade aparece em dias, não em meses.
No post sobre como testar as respostas de um agente de IA, montamos a prova antes de o agente começar a trabalhar. Aquele teste é a foto do dia. Acompanhar a qualidade é o filme: as perguntas mudam, os produtos mudam e o próprio agente pode mudar sem avisar.
Por que a qualidade do agente cai depois que ele entra em uso?
Porque quase tudo em volta dele muda, e às vezes ele mesmo muda. Em 18/07/2023, pesquisadores de Stanford e da Universidade da Califórnia em Berkeley publicaram um estudo comparando duas versões do GPT-4 com três meses de diferença. Na tarefa de dizer se um número é primo, a taxa de acerto caiu de 84% em março para 51% em junho de 2023, sem nenhum aviso para quem usava. Os autores concluíram que o comportamento do "mesmo" serviço pode mudar bastante em pouco tempo e que é preciso monitorar continuamente.
Um estudo publicado na revista Scientific Reports em 08/07/2022 testou 128 combinações de modelo e base de dados e encontrou perda de qualidade com o passar do tempo em 91% dos casos. A queda pode ser lenta ou vir de repente, depois de meses de bom desempenho.
No marketing, isso aparece de formas bem concretas: a tabela de preços muda e o agente segue citando o valor antigo, uma campanha nova traz perguntas que ninguém previu, a instrução ganha uma frase a mais e o tom fica estranho.
O que olhar toda semana?
Uma amostra de conversas reais, conferida contra o gabarito. A Anthropic, num guia sobre avaliação de agentes publicado em 09/01/2026, recomenda ler uma amostra das conversas toda semana e lembra que o retorno espontâneo dos usuários é raro e tende a mostrar só os problemas mais graves. Ou seja, esperar reclamação não basta.
Na prática, numa segunda de manhã:
- Separe a amostra: de 10 a 20 conversas da semana, sorteadas, mais todas as que terminaram em reclamação.
- Confira com o gabarito: fato, fonte, tom, limites e se o agente soube dizer "não sei" quando devia.
- Marque o resultado: certa, errada, inventada ou "não sei", na mesma planilha do teste.
- Olhe os sinais de fora: reclamações, pedidos para falar com uma pessoa e clientes que repetem a mesma pergunta.
O pedido de atendimento humano merece atenção especial. Quando alguém escreve "quero falar com uma pessoa" depois de duas respostas do agente, é bem provável que ele não tenha resolvido.
Quais indicadores usar?
Poucos e simples, medidos sempre do mesmo jeito. Este é o painel mínimo que a Oficina Martech recomenda:
| Indicador | Como medir | Frequência | Sinal de alerta |
|---|---|---|---|
| Taxa de acerto da amostra | Respostas certas divididas pelo total da amostra conferida | Semanal | Queda de 10 pontos ou mais em relação à média do mês |
| Respostas inventadas | Quantas respostas da amostra trouxeram fato que não está na base | Semanal | Qualquer resposta inventada sobre preço, prazo ou regra |
| "Não sei" do agente | Quantas vezes ele admitiu não saber e encaminhou | Semanal | Subida brusca (falta algo na base) ou zero (pode estar chutando) |
| Pedidos de atendimento humano | Conversas em que o cliente pediu para falar com uma pessoa | Semanal | Alta logo depois de uma mudança no agente ou na base |
| Tempo até corrigir | Dias entre achar o erro e corrigir a base ou a instrução | A cada erro | Mais de uma semana com o mesmo erro no ar |
Como registrar os erros?
Num registro de uma linha por erro, com quatro campos: o que o agente respondeu, o que deveria ter respondido, por que errou e o que foi mudado. A coluna "por que" é a mais útil. Com o tempo, ela mostra se o problema mora na base desatualizada, na instrução confusa ou numa pergunta que o agente nem deveria responder.
Um exemplo de terça-feira: o agente disse que o frete para Manaus leva cinco dias, mas a regra nova diz oito. Por quê? A tabela de prazos da base não foi atualizada junto com a do site. O que mudou? A tabela foi trocada e a pergunta "qual o prazo para Manaus?" entrou na lista de teste.
Quando o erro volta para o teste?
Sempre. Cada erro real vira pergunta nova do gabarito. A Anthropic recomenda exatamente isso: transformar as falhas relatadas pelos usuários em casos de teste, para que a lista reflita o uso real. Assim, a lista de 20 perguntas do primeiro teste cresce com a vida real e protege contra o erro voltar.
Rode a lista completa de novo toda vez que a base, a instrução ou o modelo mudar. É ali que a qualidade costuma cair sem aviso.
Como fazer o acompanhamento em 30 minutos por semana?
Com um roteiro fixo, sempre no mesmo dia. Este é o checklist:
- Sorteie de 10 a 20 conversas da semana e junte as que geraram reclamação.
- Confira cada resposta com o gabarito e marque o resultado na planilha.
- Conte os pedidos de atendimento humano e compare com a semana anterior.
- Registre cada erro com o que respondeu, o certo, o motivo e a correção.
- Corrija a base ou a instrução e acrescente o erro à lista de teste.
- Se algo mudou no agente, rode a lista completa antes de seguir.
Conclusão
Acompanhar um agente é como acompanhar alguém novo no trabalho depois do período de experiência: conversas conferidas, erros anotados e correções rápidas. Meia hora por semana evita que um preço ou prazo errado fique semanas no ar. Se quer ajuda para montar esse acompanhamento nos seus agentes, peça um diagnóstico com um especialista da Oficina Martech.
Perguntas frequentes
Com que frequência devo conferir as respostas do agente de IA?
Toda semana, com uma amostra de 10 a 20 conversas reais. No primeiro mês, vale olhar duas vezes por semana. Além disso, rode a lista completa de teste sempre que a base, a instrução ou o modelo mudar.
Quantas conversas preciso conferir por semana?
De 10 a 20 sorteadas já mostram tendências, somadas a todas as que terminaram em reclamação. Se o agente atende muito volume, aumente a amostra. O importante é conferir sempre do mesmo jeito para comparar uma semana com a outra.
A reclamação dos clientes não basta para saber se o agente está errando?
Não. A Anthropic observa que o retorno espontâneo é raro e tende a mostrar só os problemas mais graves. Muita gente recebe uma resposta errada e simplesmente vai embora. Por isso a amostra semanal é necessária.
O que fazer quando a taxa de acerto cai de uma semana para outra?
Veja primeiro o que mudou: base, instrução, modelo ou o tipo de pergunta que chegou. Rode a lista completa de teste para achar onde quebrou. Corrija, rode de novo e, se o erro for grave, volte a aprovar as respostas antes de enviar até estabilizar.
Pulga atrás da orelha
O agente está estável, a amostra da semana veio limpa e os erros viraram teste. Agora surge a vontade de entregar mais coisas para ele. Mas qual processo vem primeiro: o que tem mais volume, o de menor risco ou o que dá mais retorno? É o assunto do próximo post.